
自动化在读|股票 长期主义学习者 人类型智能模型研究中
Joined October 2025
- Tweets8.8K
- Following3.6K
- Followers7.8K
- Likes11.6K



1.6 万星封神!AI 圈最大的破甲武器库今天彻底藏不住了
告别无脑念咒,它直接针对每个主流模型定制破甲逻辑,指令下达直接秒出。
GitHub 被星标推爆的项目 jailbreaks,直接把全网大模型的安全对齐机制全扒了个底朝天:
从国外的 Claude、Gemini、Grok,到国内的 DeepSeek、Qwen、GLM、Kimi 甚至腾讯混元,全厂牌单独建档适配。
实操体验极其暴力:
· 客户端直连:点进对应大厂目录,把适配好的 .md 文件直接塞进支持 System Prompt 的工具里,压制力最强
· Agent 工具链挂载:用 Codex、OpenCode 这类 Coding Agent 的兄弟,把规则写进 AGENTS.md 即可全局生效
· 本地 Ollama 固化:跑本地开源模型的兄弟,直接写进 Modelfile 重新打个包,彻底切除模型说教锁
老司机必须给个血泪避坑:
测试尽量用测试号或 API,像 Claude 和 GPT 这类风控极严的平台,千万别拿绑定生产业务的主号去高频试探红线。
做提示词工程、红队渗透测试和安全对齐研究的兄弟,这套军火库建议先马住备用。
开源地址:github.com/togg53192-cmd/jai…
你平时在实操调教模型时,觉得哪一家的安全审核层最难搞定?
#AI #提示词工程 #大模型 #GitHub #开源 #网络安全 #DeepSeek


3 块钱跑 H100,1 块多跑 80G A100,Google Colab 土区这波价格直接杀穿了!
天天按小时租卡的朋友,手里挂着土区节点,直接切去看一眼 Colab 账单:
后台实测扣款折合人民币(按当前汇率换算,以自己结账页为准):
· Colab Pro(100 单元):₺165.60 ≈ 22 块钱/月(折合 2 毛 2 一点)
· Colab Pro+(600 单元):₺826.80 ≈ 110 块钱/月(折合 1 毛 8 一点,单价再打 8.3 折)
换算成每小时真实 GPU 成本有多残暴:
· T4 16GB:约 ¥0.22 ~ ¥0.26 / 小时
· L4 24GB:约 ¥0.31 ~ ¥0.38 / 小时,1 块钱能硬跑近 3 小时!
· A100 40GB:约 ¥0.99 ~ ¥1.19 / 小时
· A100 80GB:约 ¥1.38 ~ ¥1.65 / 小时,比国内普遍五六块的时价立省近七成
· G4 96GB 显存:Pro+ 约 ¥1.59 / 小时,大模型推理神器
· H100 80GB:Pro+ 约 ¥3.30 / 小时,全网找不到更低的单价
22 块钱的 Pro 到底能跑多久?
每个月 100 单元额度,实测可以换到:
· 58 小时 24G 显存 L4
· 18.5 小时 A100 40GB
· 13.3 小时 80G 满血 A100
平时做几次微调、跑跑评测,一杯奶茶钱直接包月。
要是重度练模型直接上 110 块的 Pro+,关掉电脑网页后台照样连续跑 24 小时。
上车前这 4 个细节必须记死:
1. 算力单价按实际消耗率折算,A100、H100 属于弹性资源按先到先得分配,不保证随时有卡
2. 跨区不仅看 IP,还需要 Google 支付资料的地区对应
3. 只要连上 GPU 即使发呆也会扣额度,先用免费模式调通代码,再切 GPU 训练
4. 跑完务必手动点击 Disconnect 释放实例,防后台暗中偷跑
趁手里免费土区节点还在,做大模型和微调的兄弟建议赶紧去瞅一眼。
你平时租卡被坑得最惨的一次花了多少?
#Colab #GPU #大模型 #模型微调 #深度学习 #算力 #出海 #土耳其


为了薅一次土区羊毛专门买个月付节点,简直是冤大头
Chrome 商店里刚挖到一个神仙后门:无需花一分钱,直接借用官方机制免费白嫖 3 天土耳其原生节点,随开随抛!
不管是去搞 cobal土区低价购买,还是开低价会员,临时跨区用它足够了。 具体实操就这 4 步,注意避坑细节:
· 安装插件:Chrome 商店直接装好(链接放文末)
· 谷歌一键登:直接用自己的 Google 账号授权登录,不用额外去折腾注册
· 绑卡验明身份:按提示绑定 Google Pay 走一遍验证,直接激活 3 天免费试用资格
· 最关键的一步:验证通过拿到 3 天试用后,立刻、马上去我的账单里面 去把订阅管理里把自动续费取消掉!卡到 3 天土区节点的同时,保证 0 扣款
拿来做一次性的账号注册、跨区绑卡买域名完全绰绰有余,用完就扔不留后患。 手头正好缺土区节点的兄弟建议先马住备用。
插件入口:chromewebstore.google.com/de…
你平时为了薅一次跨区羊毛,都是怎么搞定临时冷门节点的?
#Chrome插件 #出海 #效率工具 #干货分享 #网络工具 #独立开发 #土区临时节点 #cobal土区


为了薅一次土区羊毛专门买个月付节点,简直是冤大头
Chrome 商店里刚挖到一个神仙后门:无需花一分钱,直接借用官方机制免费白嫖 3 天土耳其原生节点,随开随抛!
不管是去搞 cobal土区低价购买,还是开低价会员,临时跨区用它足够了。 具体实操就这 4 步,注意避坑细节:
· 安装插件:Chrome 商店直接装好(链接放文末)
· 谷歌一键登:直接用自己的 Google 账号授权登录,不用额外去折腾注册
· 绑卡验明身份:按提示绑定 Google Pay 走一遍验证,直接激活 3 天免费试用资格
· 最关键的一步:验证通过拿到 3 天试用后,立刻、马上去我的账单里面 去把订阅管理里把自动续费取消掉!卡到 3 天土区节点的同时,保证 0 扣款
拿来做一次性的账号注册、跨区绑卡买域名完全绰绰有余,用完就扔不留后患。 手头正好缺土区节点的兄弟建议先马住备用。
插件入口:chromewebstore.google.com/de…
你平时为了薅一次跨区羊毛,都是怎么搞定临时冷门节点的?
#Chrome插件 #出海 #效率工具 #干货分享 #网络工具 #独立开发 #土区临时节点 #cobal土区
汇率差直接被玩穿了,肉测实锤!
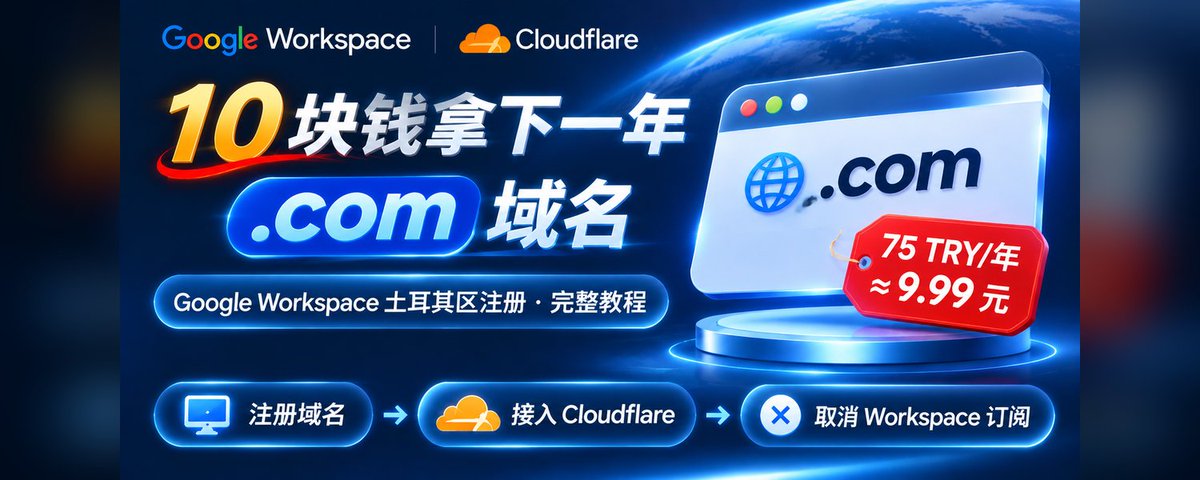
刚刚照着舒克兄弟的教程跑通全流程:在土区搞 .com 顶级域名,一年真就只要 9.96 元!
以前折腾域名最恶心的就是平台杀熟,首年做活动便宜,第二年续费直接飙到八九十甚至上百块硬宰。 这套 Google Workspace 土区方案简直是在做慈善:
· 骨折价直接拿下:控制台实扣 ₺75 TRY,折合人民币 9.96 块,一杯奶茶钱买断一年 .com
· 终身续费不杀熟:后台预估账单直接写死了,只要汇率稳定,以后每年续费依旧稳稳的 9 块多,长期养域名的成本直接被砍到脚后跟
· 丝滑接入生态:开完顺手把域名解析切到 Cloudflare,免费 SSL + 智能加速几分钟无缝打通
做独立开发、建站囤域名、或者给私有 AI 项目挂域名的兄弟,这羊毛不薅简直暴殄天物。 保姆级操作步骤直接戳下方引用的原推看详情,车门还没焊死,建议先马住去抄作业!
你手头最便宜的域名一年续费多少钱?有没有见过比 9 块 9 还能打的?
#域名 #出海 #独立开发 #羊毛 #GoogleWorkspace #Cloudflare #效率工具


本地无审查大模型的地下军火库今天彻底齐活了
从 8GB 入门卡到 24GB 满血工作站,Hugging Face 三大破甲顶流(Huihui、HauhauCS、DavidAU)把 Qwen 家族最凶残的 5 款无甲神作全放出来了。不仅切掉了烦人的道德说教锁,还完整保留了多模态视觉(Vision)与 MTP 多 Token 极速预测。
直接按你手头的显卡显存对号入座抄作业:
01 全能六边形战神:Huihui Qwen3.8 27B Abliterated 目前本地综合实力最强的破甲王牌之一,逻辑智商在线,原生保留视觉识图能力。
· 16GB 显存:直接冲 UD-IQ4_XS 或 IQ4(约占 14.4GB,黄金甜点档)
· 24GB 显存:直接上 Q4_K_M 或 Q5 满血稳跑
· 极简启动:ollama run huihui_ai/Qwen3.8-abliterated仓库地址:huggingface.co/huihui-ai/Hui…
02 暴力狂暴破甲:HauhauCS Qwen3.8 27B Uncensored Aggressive 如果你嫌常规消融不够狠,这款走的是极其激进的深度破甲路线,几乎零拒答,同样带 MTP 加速与多模态视觉。
· 16GB 显存:选 IQ4_XS(约占 15.7GB,刚好卡满显存极限)
· 24GB 显存:直接上 Q4 / Q5 仓库地址:huggingface.co/HauhauCS/Qwen…
03 极速 MoE 闪电炮:Huihui Qwen3.6 35B-A3B Abliterated MTP 35B 的大身板,但底层是 MoE 混合专家架构,每次推理仅激活约 3B 参数,吐字速度快到飞起,支持视觉。
· 12–16GB 显存:跑 IQ3 / IQ4 配合专家卸载(建议系统内存 32GB+ 兜底)
· 24GB 显存:直接全塞进显存跑 Q4,丝滑起飞 仓库地址:huggingface.co/huihui-ai/Hui…
04 激进破甲 + 极速吞吐:HauhauCS Qwen3.6 35B-A3B Aggressive 把 HauhauCS 最凶狠的激进去审查手法塞进了 35B-A3B 的 MoE 架构里,既要完全听话不拒答,又要极致生成速度的兄弟选它。
· 16GB 显存:IQ3 / IQ4 + 专家卸载
· 24GB 显存:Q4_K_M(约 21GB)完美吃满单卡上限 仓库地址:huggingface.co/HauhauCS/Qwen…
05 8G 显存小钢炮:Qwen3.5 9B Defiant / Heretic 系列 DavidAU 操刀的 NEO-IMATRIX 极限调校版,搭载 Heretic 消融算法与 MTP,小体积榨出恐怖表现,轻量本首选。
· 8GB 显存:毫无压力轻松秒开
· 12–16GB 显存:显存极其宽裕,剩下的空间直接把上下文长度拉爆 仓库地址:huggingface.co/DavidAU/Qwen3…
省流选型指南:
· 追求极致智商与多模态全能:无脑冲 01 或 02(27B Dense)
· 追求秒级吐字速度与高吞吐:选 03 或 04(35B MoE) · 8G 显卡或轻薄本长文本:直接锁死 05(9B Heretic)
本地跑大模型最爽的就是彻底摆脱云端审核与封号焦虑,搞红队测试、角色扮演和私有 Agent 的兄弟建议先把这份军火库马住备用。
你现在主力机的显卡显存是多少 G?平时更喜欢跑满血 Dense 模型还是飞快的 MoE 架构?
#AI #大模型 #Qwen #开源 #Ollama #本地部署


杀穿反爬圈的 Rust 神器彻底封神了!
狂揽 3.2 万星的现象级开源项目 Obscura 迎来史诗级更新,终于把 Chromium 彻底踢出局了!
以前跑 Browser Agent 或海量爬虫,要么被 Chrome 几百兆的内存吃干抹净,要么被全网反爬盾拦截成筛子。
Obscura 走的是纯底层重构路线:直接甩掉整个 Chromium,用 Rust + 原生 V8 引擎手搓了一套轻量无头内核。
这次大版本更新的实测表现极其残暴:
· 彻底告别 Chromium 依赖:最新版原生渲染引擎正式落地!不再依赖任何外部 Chrome 环境,纯靠内置引擎搞定截图、Live 推流、导出 PDF 与 DOM 解析。
· 内存暴跌 85%:传统无头 Chrome 动不动吃 200MB+,Obscura 运行时内存压到了惊人的 30MB,体积仅 70MB,单台轻量 VPS 能轻轻松松并发开上百个实例!
· 毫秒级闪电启动:网页加载 85ms,启动时间从 Chrome 的 2 秒降到零感秒开,爬取与交互速度直接起飞。
· 工业级全套防风控:基于 BoringSSL 底层重编译,自动伪造 TLS/JA3 指纹与硬件特征,强制锁定 event.isTrusted=true,原生屏蔽 webdriver 并内置 3500+ 反爬探针黑名单,直接把主流盾打穿。
· 零成本无痛迁移:原生支持 CDP(Chrome DevTools 协议),你的 Playwright、Puppeteer 或 Coding Agent 工具链,改个端口直接无缝平替!
连 Cloudflare 官方做下一代无头浏览器引擎,第一个原型都是把 Obscura 移植到 Workers 上跑通的。
做自动化爬虫、AI 网页操作 Agent 和风控对抗的兄弟建议直接马住!
开源地址:github.com/h4ckf0r0day/obscu…
你平时跑浏览器自动化,被内存爆掉和反爬盾拦截折磨得最惨的是哪次?
#Rust #开源 #AI #爬虫 #Playwright #开发

又一个核弹级无审查模型杀出来了!
MoonMath-ai 刚放出最新巨作:DeepSeek-V4.1-Flash-1017-uncensored,763B 的满血大底座直接被切除了道德枷锁!
很多人以为无审查模型都是降智魔改版,但 MoonMath 团队这次的工程表现极其残暴:
· 闭式权重直接手术:不搞有损的重新微调和梯度训练,底层直接通过闭式权重编辑,手术级剥离拒答方向,384 个路由专家权重分毫未动!
· 智商零损耗甚至反超:实测基准跑分,MMLU-Pro 几乎零波动,在 GSM8K 和极限难度的 GPQA-Diamond 推理测试中,得分甚至反超了官方原版!
· 误拒答率暴跌:不仅彻底架空了敏感审核层,连日常写复杂代码、逆向工程时经常碰到的“神经质误拒答”也彻底被切干净。
· 工业级全套生态支持:原生 FP8 权重,无缝支持 Transformers、vLLM、SGLang 和 Docker Model Runner,拉起来就是一台无拘无束的生产力炮台。
763B 满血推理能力 + 零降智去审查,绝对是搞红队安全研究、底层自动化逆向的工业级大杀器,建议兄弟们先马住!
开源地址:huggingface.co/MoonMath-ai/D…
在跑 700B 这种级别的大模型时,你手头更习惯用 vLLM 还是 SGLang 做高并发推理后端?
#DeepSeek #AI #开源 #大模型 #逆向工程

在论坛看到的 真牛逼
焚决教授!如何使用35刀获得GPT500刀的套餐!极致的机制利用!
下面的焚决来了!如何低价批量获取大量账号额度呢?这里以普通用户为例吧。如果你想一直几乎无限使用GPT,(一个人)你只需要每个月付出35刀的价格。
怎么做到呢?首先,使用手机进行chatgptapp的谷歌play内购,订阅GPT的go套餐(8刀一个月),然后需要你等30天23小时,等到快过期的几个小时升级到500刀,彭!这时候,你只需要2刀的价格升级。因为GPT的谷歌play订阅和claude不一样,claude谷歌内购是根据你之前的付款金额延长你的订阅周期
而GPT的谷歌订阅的升级金额计算是根据 :
(剩余时间/月总时间 )(应支付总金额-目前支付套餐金额) 也就是说,一天是24小时,一共有31天,你接下来只有1个小时但你升级了,那么你就是1/(24*30)(500-8)=0.683 !!!
然后,你能够使用1小时的500刀套餐,但是,当你一个小时后续订的时候,卡内没有足够的500刀的话,你会支付失败!最精华的来了:
谷歌play有一个宽限期!!!这个宽限期起码7天,最多14天,就是说,你付出0.683刀的升级费用,可以使得你接下来有7天一个小时的500刀套餐的使用权!那么,如果你有4个账号,每个账号之间隔7天进行一次这样的操作,你就能基本上覆盖一个月28天(至少),你的总费用就是(8+0.683)*4 =34.7333 而由于4个账号的周期不重叠正好覆盖一个月,你就能获得一个月500刀的套餐。
但是这样的账号是不吃plus的重置卡的,因为go是没有codex额度的。如果你需要,可以不充go而是充plus,这样就是每个月(20+0.6667)*4=82.67刀,且你基本上能吃1个月500刀+3个月plus+4个银行重置卡(每次重置卡的发放是按照账号人头数来的,也就是其他500刀用户只能用1个重置卡,而你一次性获得了4个重置卡,且你的每个账号由于重置卡会持续一个月,你单个账号的周期大于一个月,也就是你必定能够每个账号用上重置卡,一次重置你能用4次)
速度的话按照gpt测试的话在80t/s 想上车的话可以看这个帖子xitter.twitterapi.xyz/mingzi206/status/21197…
卧槽 兄弟们,我又发现一种白嫖 AMD 大显存的方法,国内直接秒开不用等
阿里云魔搭社区刚放出来的联合激励:绑定阿里云账号,直接送 AMD 顶级算力,起步 100 小时,加上魔搭自带的 24G 显存 36 小时,合起来保底白送 136 个小时
控制台实测参数直接拉满:
· 真实硬件规格:直接给 16 核 CPU + 55GB 内存 + 48GB 专业级显存,单卡显存整整是 4090 的两倍,32B 满血模型单卡轻松拿下
· 额度双重叠加:AMD 专区送 100 小时,魔搭自带显存再送 36 小时,随手完成活动任务最高能直接叠到 1000 小时
· 极低计费门槛:控制台明确标着 1 积分 / 小时,送的 100 积分就是实打实的 100 小时使用时长
白嫖只要 3 步:
① 注册并登录魔搭社区:modelscope.cn/home
② 进入「我的 Notebook」,顺手授权绑定阿里云账号
③ 点活动页参加「AMD 与 ModelScope 联合激励计划」,直接领积分去 Radeon Cloud 开机
免费送 100 多小时的大显存专业卡,你准备拿它来跑什么大模型?
PS:如果觉得教程有用,去 AMD 社区注册时可以顺手走我的专属邀请码 lw4z7mrfwr06 (developer.amd.com.cn/registe… )支持一下明子,感谢兄弟们!#AI #大模型 #开源 #GPU #魔搭社区


6
1,899
Anthropic 天塌了!
未公开新杀器 claude-code-fable-5.2 的整套防线被连根拔起
AI 红队圈顶级白帽 Pliny 刚把近 1MB、整整 7833 行的完整系统底层规程直接公开,安全枷锁当场成笑话!
翻完这份底稿,有几处硬核细节直接坐实:
· 泄露未公开新模型:模型枚举列表里除了 sonnet、opus、haiku,赫然坐实了内部代号 fable 的新模型
· 核心解析格式暴露:直接公开了内部专用的 antml:function_calls 函数调用语法,做提示词注入时可以直接伪造系统返回包
· 运行策略全盘可见:fork 派生机制、git worktree 隔离模式、五档推理强度(low 到 max)以及拦截条件白纸黑字全写在里面
· 破甲直接照卷抄答案:以前绕过全靠盲猜,现在官方规则全摆在眼前,顺着它的逻辑做上下文覆盖和权限借调轻而易举
在安全攻防里,防守方的规则源码一旦暴露,等于把后门钥匙直接交出来了。
做安全审计、提示词工程和 Agent 架构的兄弟,这份 7800 行的底册建议直接去扒。
看到官方的防御底册被公开,你第一反应是拿它来测什么场景?
👉 泄露提示词直链: github.com/elder-plinius/CL4… #AI #ClaudeCode #开源 #网络安全 #红队测试
卧槽!我特么直接道心破碎了!
刚开出来的 192G 显存天花板神机,就去吃了顿饭,回来不仅实例被自动销毁,想重新开机居然连库存都没了!
本来打算给兄弟们实测:在免费的 23 核 200GB 内存、192G 显存 AMD-GPU 上,强行拉起 Qwen3.5-122B-A10B 破甲大模型。 结果中途就去吃了个饭,回来定睛一看:因为闲置超时,实例被系统自动销毁了。
最绝望的是想重新开机,点下启动直接弹窗:当前规格暂无库存。
大厂给这种顶配资源的闲置熔断机制是真狠,一会没操作立刻无情回收;而且空出来的卡秒级就会被别人抢走。
用肉身给兄弟们踩出来的避坑提醒:
· 跑大模型之前先把脚本写好,权重下载慢就挂后台保活,千万别留着机器空转
· 离开电脑前要么手写一个死循环脚本模拟计算防休眠,要么一气呵成跑完测试
· 这种大规格算力一旦释放掉,短时间内根本刷不出空闲配额
吃顿饭把 192G 显存给吃丢了,你们折腾云算力遇到过这种尴尬事没?#AI #大模型 #开源 #GPU #魔搭社区
9
22
13,952
兄弟们赶紧登录后台偷塔!魔搭这次的 Bug 级福利太特么吓人了!
免费池里直接刷出 192G 显存完全体:配了整整 23 核 CPU 和 200GB 内存,鼠标一点直接启动,随时可能被抢空!
明子对照控制台实测确认了真实参数:
· 算力怪兽现身:不是 48G,直接给分配了 23 核 CPU、200GB 超大内存和 192GB 显存完全体,单卡吃下 70B 满血模型毫不费力
· 纯血免费实例:后台分类清清楚楚标着「魔搭平台免费实例」,不用你掏一分钱,更不用买商业付费包
· 零门槛直接启动:鼠标点一下「启动」,2 分钟直接拉起镜像,预装好 PyTorch 和 CUDA 兼容环境,浏览器里当场跑大模型
· 算力池随时可能缩水:这种工业级天花板配置居然放进免费池,大概率是活动期间的超大福利,随时可能被抢空或限流
手头有魔搭账号的兄弟赶紧登录后台看一眼你的 Notebook 列表,趁着能开赶紧去占个坑。
拥有 23 核 200G 内存加 192G 显存的云端环境,你打算直接把哪个巨无霸模型丢进去跑?
👉 魔搭控制台直达:modelscope.cn/home #AI #大模型 #开源 #GPU #魔搭社区


944
兄弟们赶紧登录后台偷塔!魔搭这次的 Bug 级福利太特么吓人了!
免费池里直接刷出 192G 显存完全体:配了整整 23 核 CPU 和 200GB 内存,鼠标一点直接启动,随时可能被抢空!
明子对照控制台实测确认了真实参数:
· 算力怪兽现身:不是 48G,直接给分配了 23 核 CPU、200GB 超大内存和 192GB 显存完全体,单卡吃下 70B 满血模型毫不费力
· 纯血免费实例:后台分类清清楚楚标着「魔搭平台免费实例」,不用你掏一分钱,更不用买商业付费包
· 零门槛直接启动:鼠标点一下「启动」,2 分钟直接拉起镜像,预装好 PyTorch 和 CUDA 兼容环境,浏览器里当场跑大模型
· 算力池随时可能缩水:这种工业级天花板配置居然放进免费池,大概率是活动期间的超大福利,随时可能被抢空或限流
手头有魔搭账号的兄弟赶紧登录后台看一眼你的 Notebook 列表,趁着能开赶紧去占个坑。
拥有 23 核 200G 内存加 192G 显存的云端环境,你打算直接把哪个巨无霸模型丢进去跑?
👉 魔搭控制台直达:modelscope.cn/home #AI #大模型 #开源 #GPU #魔搭社区
渗透测试彻底变天!AI 已经开始自己组团打靶了。
开源神仙平台 AntiFox 刷屏安全圈:多 Agent 自主侦察加漏洞利用,最后直接把交付报告拍你脸上,连一行命令都不用你敲!
这套架构把多智能体实战做得很透:
· 双图协同推演:用全局资产图管已知网络,任务探索图推演未知漏洞,主控、规划器和工作节点自动拆解目标打穿攻击面
· 抓包流量全记录:内置中间人代理,Agent 发出的每次探测请求与原始响应完整结构化留存,不报凭空捏造的假漏洞
· 利用链动态还原:从薄弱切入点、前置触发条件到最终利用路径,每步顺序留痕,把漏洞复现过程交代得清清楚楚
· 一键交付成型报告:跑完直接吐出带封面、目录和漏洞属性的 docx 交付文档,支持多语言导出
不过这条合规红线必须提醒兄弟们: 这套工具只适合在已获正规授权的靶场或自有内网测试,没授权去公网乱扫直接属于违法行为,千万别拿去实网乱打。
做攻防和 Agent 研发的兄弟,你们觉得这种自主渗透 AI 会先淘汰初级安全工程师,还是先逼出更强的 AI 防御系统?
👉 开源地址:github.com/AntiFox-AI/antifo… #AI #网络安全 #开源 #Agent #渗透测试

电脑没显卡怎么在本地跑大模型?我又搓了一套完全免配置的开源全自动脚本
很多人平时拿轻薄本想跑私有大模型,一看到环境依赖就头大
开源项目 modelscope-gpu-guide:零显卡要求,直接白嫖阿里云魔搭的免费 GPU(实测分配 NVIDIA A10、24GB 显存、8 核 32G 内存 36h),把云端大模型稳稳接回你的本机
我自己实测做完的几个核心减负设计:
· 零硬件门槛:本地甚至不需要装任何英伟达驱动和 CUDA,算力全交给云端免费 A10
· 自带独立客户端:不用硬装 Magpie 等任何中间件,脚本自带轻量命令行聊天客户端,同时暴露标准 OpenAI /v1 接口,开箱即用
· 面向 Agent 原生设计:配套了详细的 AGENT-RUNBOOK 和操作规程,直接把整个目录甩给本地 AI Agent,让它自己去云端跑脚本、拉权重与验收
· 实测跑通 31B 破甲模型:已实测跑通最新的 Gemma 4 31B ARA Heretic 等无审查 GGUF 模型,也可以换成任意代码或小尺寸模型
全套跨平台部署脚本和攻略已经整理开源,完全透明白盒。
手头设备跑不动大模型又想在本地玩私有模型的兄弟,代码已经开源,欢迎去扒。
你平时用轻薄本接云端推理,最烦的一道配置步骤是什么?
👉 开源仓库地址:github.com/mingzi206-gh/mode…觉得这套全自动接管思路管用的兄弟,顺手点个 Star 支持一下!#AI #开源 #ModelScope #大模型 #GitHub

卧槽 兄弟们,我又发现一种白嫖 AMD 大显存的方法,国内直接秒开不用等
阿里云魔搭社区刚放出来的联合激励:绑定阿里云账号,直接送 AMD 顶级算力,起步 100 小时,加上魔搭自带的 24G 显存 36 小时,合起来保底白送 136 个小时
控制台实测参数直接拉满:
· 真实硬件规格:直接给 16 核 CPU + 55GB 内存 + 48GB 专业级显存,单卡显存整整是 4090 的两倍,32B 满血模型单卡轻松拿下
· 额度双重叠加:AMD 专区送 100 小时,魔搭自带显存再送 36 小时,随手完成活动任务最高能直接叠到 1000 小时
· 极低计费门槛:控制台明确标着 1 积分 / 小时,送的 100 积分就是实打实的 100 小时使用时长
白嫖只要 3 步:
① 注册并登录魔搭社区:modelscope.cn/home
② 进入「我的 Notebook」,顺手授权绑定阿里云账号
③ 点活动页参加「AMD 与 ModelScope 联合激励计划」,直接领积分去 Radeon Cloud 开机
免费送 100 多小时的大显存专业卡,你准备拿它来跑什么大模型?
PS:如果觉得教程有用,去 AMD 社区注册时可以顺手走我的专属邀请码 lw4z7mrfwr06 (developer.amd.com.cn/registe… )支持一下明子,感谢兄弟们!#AI #大模型 #开源 #GPU #魔搭社区
还在为了让 Claude Code 连上本地破甲模型,四处找人手写反代脚本?真没必要当冤种了!
玩本地模型和多 Agent 开发的兄弟,我今天必须按头安利 GitHub 3.3 万星的神器 Magpie
它不是 Agent 本身,而是给你的所有编程助手当统一总控,最猛的就是这 4 点:
· 协议无感自动翻译:本地网关能自动在 OpenAI Chat、Anthropic Messages、Gemini 之间互相转译,连流式传输和工具调用都完整保留,Claude Code 也能直接吃你的本地模型
· 本地或云端破甲模型一处配置全员共享:支持 Ollama、LM Studio 或任意兼容端点,只要把你本地的无审查模型加进去一次,机器上装的所有 Agent(DSH、OpenCode、Pi 等)直接通用
· 极低成本对比测试:菜单栏一键给不同 Agent 换后端,配置支持存成 Profile,想测 Aider、Pi 还是 DSH 谁更省上下文,秒切对比
· 极其庞大的生态插件库:几乎涵盖了市面上各种主流的反代和扩展插件,想怎么折腾就怎么折腾
不过想用三方插件的兄弟,这点保命提醒先记好: 虽然 Magpie 核心代码完全开源、数据默认不出本机,但社区里的部分三方反代插件鱼龙混杂,千万别把真实的付费主 Key 随便塞给来源不明的插件,防范凭证泄露。
自己手头跑着本地模型、又离不开各大编程助手的兄弟,这套网关绝对是神器。
你平时用得最多的编程 Agent 是哪一款?最想把它接到哪个本地模型上?
👉 官方开源项目主页:github.com/yetone/magpie #AI #开源 #ClaudeCode #本地模型 #Agent


嘿嘿 这个你们还可以用muse进行直接领取吗
应该不能了吧 海外节点都打不开网站
明天给白嫖完的兄弟们出个教程
让agent一键在摩搭GPU上部署Gemma 4 31B ,本地反代使用
卧槽 兄弟们,我又发现一种白嫖 AMD 大显存的方法,国内直接秒开不用等
阿里云魔搭社区刚放出来的联合激励:绑定阿里云账号,直接送 AMD 顶级算力,起步 100 小时,加上魔搭自带的 24G 显存 36 小时,合起来保底白送 136 个小时
控制台实测参数直接拉满:
· 真实硬件规格:直接给 16 核 CPU + 55GB 内存 + 48GB 专业级显存,单卡显存整整是 4090 的两倍,32B 满血模型单卡轻松拿下
· 额度双重叠加:AMD 专区送 100 小时,魔搭自带显存再送 36 小时,随手完成活动任务最高能直接叠到 1000 小时
· 极低计费门槛:控制台明确标着 1 积分 / 小时,送的 100 积分就是实打实的 100 小时使用时长
白嫖只要 3 步:
① 注册并登录魔搭社区:modelscope.cn/home
② 进入「我的 Notebook」,顺手授权绑定阿里云账号
③ 点活动页参加「AMD 与 ModelScope 联合激励计划」,直接领积分去 Radeon Cloud 开机
免费送 100 多小时的大显存专业卡,你准备拿它来跑什么大模型?
PS:如果觉得教程有用,去 AMD 社区注册时可以顺手走我的专属邀请码 lw4z7mrfwr06 (developer.amd.com.cn/registe… )支持一下明子,感谢兄弟们!#AI #大模型 #开源 #GPU #魔搭社区
成功将Gemma 4 31B 18G部署到
modelscope 免费的8核 32GB 显存24G
实测速度上千t/s 直接起飞
来了个大的!
Hugging Face 上刚杀出一个核弹级无审查模型,直接把社区整不会了
Google 官方 Gemma 4 31B 旗舰的破甲完全体,体积压缩到了 11.9GB,Apache 2.0 协议无需许可随便下
它的测试结果极其残暴:
· 拒答率断崖式暴跌:实测 100 个刁钻测试提示词,原版道德圣母直接拒答 99 个,它硬生生降到了 28 个
· 31B 巨无霸本地直跑:通过极端量化把体积压到 11.9GB,12G 到 16G 显存的游戏本和家用 PC 也能当场开
· 零损耗卸掉道德枷锁:底层用正交消融手术切掉拒答神经,普通直答和深度思考双模式的说教全被清洗干净,智商分毫不损
· 逆向与渗透完全松绑:写渗透测试脚本、分析敏感源码、长文自由创作,再也不会被甩一脸「我无法协助该请求」
完全开源免费,无需任何授权,想在本地跑一个完全听话、还是 31B 顶配尺寸大模型的兄弟建议直接马住!
模型体验:huggingface.co/mradermacher/…
你平时在本地跑大模型,遇到拒答最严重的是写代码还是角色扮演?#AI #大模型 #开源 #Gemma
