Pinned Tweet
世界最速※のAIエンジン「YASAKANI」を、3日後の11/13(金)22時に無料公開します。
RTX 5090 1枚で 1,260 tok/s、他の8エンジンに全7分野で勝利。圧縮の品質でも、近い容量のGSQ-RCO・Unslothを上回りました。
もっと多くのPCに対応するため、クラファンを始めました。詳細はこちら↓
camp-fire.jp/projects/992233…
・速くする仕組みはRTX 5090専用ではありません。ほかのGPUにも広げていきます
・Qwen4にも、重みが公開されたらすぐに対応する予定です
・現在の対応はWindowsとRTX 5090です
・ソースコードと2つのモデル(最速・品質)をApache-2.0で公開
ご支援で対応GPUを広げます。累計300万円でRTX 3090・4090などの24GB・16GB機へ、その先はAMD・Macへ。1,000円から応援できます。
【動画と画像について】
・動画の48秒からは、実際に生成している画面の録画です。カットも早送りもなく、編集していません。別ウィンドウのタイマーも一緒に映しています(コードの書き換えが5.56秒で完了)
・画像1・2枚目:思考なし/思考ありの速度表(大きいほど速い)
・画像3枚目:圧縮品質の表(元のモデルにどれだけ近いか。KLは小さいほど近い)
※RTX 5090 1枚・Qwen3.8-27B・単一生成。掲載した8エンジン・7分野の比較条件での記録です。1,260 tok/sは長いJSONLの生成(思考なし)。品質は、自前の思考文で元モデルとの近さを近い容量どうしで比べた結果です。
#YASAKANI
YASAKANIエンジンで、RTX 5090 の単一デコード 1,220 tok/s を達成!!
今回は世界最速のエンジンである証明をしました。
RTX 5090 1枚・Qwen3.8-27B・1本の生成で、公開されている最速記録を5本すべて上回った(定格・同じ土俵の条件で、最大2.5倍)。
「5090で最速」を名乗る MegaCapybara 1.39 とは、同じPC・定格・同じ問題で直接対決。動画は実際の生成を、記録した時刻どおりに再生しています。
■ 公開記録 → YASAKANI(tok/s)
- mkyt(JSON)500 → 1,220(2.44倍)
- NInfer(構造化3問)377 → 937(2.49倍)
- TensorFold(英語)298 → 424(1.42倍)
- ignis(コード)491 → 532(1.08倍)
- MegaCapybara(コード)540※ → 498(同じPC・定格では466、1.07倍)
※540はメモリ+20% OCと自前のプロンプトでの値
■ 同じPCで直接対決(MegaCapybara 1.39 Tiny、思考オフ・greedy)
- JSONL 160行:1,220 vs 635(1.9倍)
- 英語の推理小説:424 vs 253(1.7倍)
- 中→英 翻訳:613 vs 366(1.7倍)
- SQL:745 vs 603(1.2倍)
- コード編集(ファイル全文の書き戻し):1,241 vs 440(2.82倍)
- JSONL 8,192トークン:1,260 vs 666(1.89倍)
12問の平均でも、構造化1.4倍・散文1.6倍・翻訳1.6倍。
■ エージェントの仕事ほど速い
コード編集は「約4,700トークンのファイルを1か所直して、全文を返す」課題。AIエージェントが毎日やっている作業です。
3つのエンジン(YASAKANI 高速版・標準版・MegaCapybara)の出力は完全に同じ(4,711トークンが一致)で、違うのは速さだけ:1,241 / 1,136 / 440 tok/s。
■ Qwen推奨設定(思考あり・温度1.0)でも
雑談・説明・コード・数学・JSON・長文入力の6課題の中央値:YASAKANI 381、SGLang 184、vLLM 183、llama.cpp 147(10/18、同じPC、他社は課題ごとに一番速い設定)。
この条件で250 tok/sを超える公開記録は、10月中旬の調査では見つかっていません。
■ 長い文脈でも
25万トークンの文書を140秒で読み、続きの返事は0.3秒で開始。25万トークンを積んだ状態でも152 tok/s。262,144トークンの窓でVRAM 24.9GB(32GBのカードに収まる)。(10/30計測)
■ 速いだけではない
元モデルとのズレ(KLD):標準版 12.4GB で 0.021。MegaCapybara Tiny は 0.058(16.6GB)。
1,220 は高速版(11.7GB、KLD 0.044)。標準版でも 1,114。
■ 正直に書いておくこと
- ゼロから書くコードは僅差(1.04〜1.08倍)。540はOC込みの値で、定格では向こうも406〜533
- MegaCapybara以外の相手の数字は各自の公表値(別のPC・別のプロンプト・別の日)。同じPCで測ったのはMegaCapybaraだけ
- 中国語の物語は英語より遅い(176〜302 tok/s)
- 第三者の再現は公開後。それまでは「この条件で測って」と言われれば、同じPCで測って出します
■ 測り方
RTX 5090 ×1(定格600W・OCなし)、Windows、2026-11-03。NInferが公開している12問(コード3・物語3・翻訳3・構造化3)+自作のコード編集・長いJSONL。上限4,096トークン(長いJSONLは8,192)、思考オフ、greedy。速度=(出力トークン数−1)÷生成時間(読み込みは除く)。MegaCapybaraは公開版1.39を公式の1会話設定で起動し、向こうのサーバーの表示とこちらの計測は一致。
エンジンもモデル形式も自作。オープンソース・無料で公開予定。日程はこのアカウントで。
#YASAKANI
■ 訂正(英語の推理小説)
本文の「英語の推理小説 424 vs 253(1.7倍)」と「TensorFold 298 → 424(1.42倍)」は、YASAKANI の出力が途中(約2,300トークン目)から同じ文の繰り返しに入った回の数字でした(greedy で起きる繰り返し。MegaCapybara は入らなかった)。繰り返しの部分は速く出て数字が上がるので、両方とも最初の2,000トークンで比べ直しました。
- 英語の推理小説:303 vs 238(1.3倍)
- TensorFold(英語)298 → 303(1.02倍、ほぼ互角)
- 12問の平均の散文:1.6倍 → 1.4倍
ほかの問題(JSONL・SQL・翻訳・コード・コード編集・長いJSONL)は、どちらのエンジンも出力がループしていないことを確認しました。動画の 424・425 は繰り返しを含んだ値です。
■ 再現用の細かい条件(画像:公開記録の一覧/同じPCの直接対決/品質と大きさ)
- 12問は NInfer の公開 fixture そのまま。コード編集は自作の1問(Python標準ライブラリの textwrap モジュールで、変数名を1つ変えて全文を返す)、長いJSONLも自作(注文データ300行の指示、8,192トークンで打ち切り)
- 同じプロンプトを1本ずつ streaming で受けて (トークン数−1)÷生成時間
- MegaCapybara 側は公式の「1会話」プリセットの既定のまま。変えたのは繰り返し検出を切った1点だけ(こちらも切ってある)。キャッシュの精度を上げた設定でも結果は同じ
- 向こうの TypeScript 問題は毎回150〜200トークンで tool_call 扱いになって止まったので、その回は集計から外した
- 生成ログ・サーバーログ・GPUの状態(nvidia-smi)は保存してある。公開時に一緒に出します
世界一速い推論エンジン「YASAKANI」。
RTX 5090・Qwen3.8-27Bで、SGLang・vLLM・llama.cppに全10テスト全勝(最大2.86倍)。
その27Bが、指示1回・人の手ゼロでこの深海を作りました。
オープンソースで、無料で公開する予定です。日程はこのアカウントでお知らせします。
#AbyssBench #YASAKANI
---
■ 同じPC・同じモデルで直接比較(RTX 5090・Qwen3.8-27B、2026-10-18実測)
答えを書く速さ、思考ありの6種類の中央値(tok/s)
- YASAKANI 380.6
- SGLang 183.9
- vLLM 182.9
- llama.cpp 146.9
全10テストで最速。他社の一番速い設定より1.69〜2.86倍。
※他社は各テストで一番速い設定(DFlash 2/DSpark/MTP)、YASAKANIは2回測った遅い方。SGLang・vLLMはWSL2、YASAKANIはWindows。別のテストでExLlamaV3(MTPあり)にも2.39倍。TensorRT-LLMはMTP設定がRTX 5090で動かず未比較。
■ 12.4GBの独自形式 .mgtm(勾玉)
- 業界標準のGGUF Q4_K_M(17.4GB)より5GB軽い
- 同じ12GB級で最良の公開GGUF(unsloth UD-IQ3_S)と比べ、元モデルとのズレ(KLD)は約半分:0.021 vs 0.039
- 最新研究 GSQ-RCO(IQ3_S)とも:0.021 vs 0.044
(WikiText-2・C4・FineWeb-Edu、ctx 2048、同じPCで測定)
■ 専用エンジン YASAKANI(八尺瓊)
- 25万トークンの文書を140秒で読む(約1,800 tok/s)。続きの返事は0.3秒で開始
- 25万トークンを積んだ文脈でも152 tok/s
- 262,144トークンの窓でVRAM 24.9GB。KVも独自圧縮で容量1/3、品質はほぼ落ちない
■ 深海ベンチマーク #AbyssBench
どちらもワンショット(プロンプトは1回だけ、途中で人は口を出さない)
- エージェント部門(自分で描画→画像を見る→修正):33手・19分04秒・エラー0。コード生成 477 tok/s、思考込み平均 284 tok/s
- チャット部門(返事1回で一発出力):6分19秒・101,816トークン・269 tok/s
あなたのモデルでも試してください。HTML 1ファイルをChromeで開いて、スクショを #AbyssBench で(部門と何回目の試行かも添えて)。
プロンプト(このままコピペ可)↓
Design and create a very creative, elaborate, and detailed 3D scene of a bioluminescent deep-sea world at night: pulsing glowing jellyfish, schools of fish swimming in formation, an anglerfish with a glowing lure, coral and sea anemones, drifting plankton particles, and a small submarine whose headlights cut volumetric beams through the dark water. Everything should glow, drift, and animate so it feels alive, with an orbit camera I can drag with the mouse. Make it mesmerizing and atmospheric. Use whatever libraries to get this done but make sure I can paste it all into a single HTML file and open it in Chrome.
4,383 tok/s on ONE RTX 5090 — 64 concurrent requests.
Single-request decoding: 432.2 tok/s — approximately 1.6× vLLM.
Flint 40B-A2.5B, measured on the same PC and GPU.
YASAKANI / vLLM (tok/s):
Single request: 432.2 / 266.5
32 concurrent: 2,961 / 2,819
64 concurrent: 4,383 / 3,782
Against llama.cpp Q3_K_L at 32 concurrent requests: 2,969 / 954 tok/s (3.11×), with model weights of 20.5 / 20.6 GB.
Single-request figures are median decode speeds across 32 prompts. Concurrent figures are aggregate throughput, including prompt processing, with 512 output tokens per request.
Speed setups: YASAKANI custom 4-bit on Windows (20.5 GB) vs vLLM official NVFP4 on WSL2 (22.9 GB). Standard generation. These are research-build results under the stated conditions.
Versions: vLLM 0.32.1rc1.dev353+g2d40c0609; llama.cpp b11804-c7fc50941.
The video aligns separately recorded runs at the start. The llama.cpp tail is visibly marked 4× playback; counters retain measured times.
The quality panel uses a separate mixed 4/8-bit model: 20.635 GB, 85.14% Top-1 agreement with BF16, PPL 12.959 over 53,196 prediction positions. Top-1 agreement is not task accuracy; runtime and KV formats differ. The speed footage uses the original 4-bit model.
These are the current results for YASAKANI, a local AI inference engine I am developing independently.
I plan to release it free and open source. The release date will be announced on this account.
RTX 5090 1枚で、4,383 tok/s!
シングルでも432.2 tok/s、vLLM比 約1.6倍。
ローカルAIエンジン「YASAKANI」の実測です。
※4,383 tok/sは64件同時の合計処理速度(入力処理込み)。
Flint 40B-A2.5B/同じPC・同じGPUで比較
YASAKANI / vLLM(tok/s)
シングル:432.2 / 266.5
32件同時:2,961 / 2,819
64件同時:4,383 / 3,782
llama.cpp Q3_K_Lとの32件同時比較は、2,969 / 954 tok/s(3.11倍)。モデル容量は20.5 / 20.6GB。
シングルは32問の生成速度中央値。同時処理は各512トークン、入力送信から全件の出力終了までを測定。映像は各エンジンを別々に測った記録を開始位置をそろえて再生しています。llama.cppの後半は4倍速と表示し、カウンターは実測値のままです。
速度の構成:YASAKANIは独自4bit・Windows・20.5GB、vLLMは公式NVFP4・WSL2・22.9GB。通常の生成。vLLM 0.32.1rc1.dev353+g2d40c0609、llama.cpp b11804-c7fc50941。研究版・表示条件での結果です。
品質表は別構成の混合4/8bit版:20.635GB、元BF16とのTop1一致率85.14%、PPL 12.959。同じ53,196予測位置で評価。Top1は課題の正答率ではなく、計算・KV形式の差も含みます。速度映像は従来4bit版です。
個人で開発しているローカルAIエンジン
「YASAKANI」の、現状の結果です。
オープンソースで、無料で公開する予定です。
日程はこのアカウントでお知らせします。
RTX 5090 1枚で、4,383 tok/s!
シングルでも432.2 tok/s、vLLM比 約1.6倍。
ローカルAIエンジン「YASAKANI」の実測です。
※4,383 tok/sは64件同時の合計処理速度(入力処理込み)。
Flint 40B-A2.5B/同じPC・同じGPUで比較
YASAKANI / vLLM(tok/s)
シングル:432.2 / 266.5
32件同時:2,961 / 2,819
64件同時:4,383 / 3,782
llama.cpp Q3_K_Lとの32件同時比較は、2,969 / 954 tok/s(3.11倍)。モデル容量は20.5 / 20.6GB。
シングルは32問の生成速度中央値。同時処理は各512トークン、入力送信から全件の出力終了までを測定。映像は各エンジンを別々に測った記録を開始位置をそろえて再生しています。llama.cppの後半は4倍速と表示し、カウンターは実測値のままです。
速度の構成:YASAKANIは独自4bit・Windows・20.5GB、vLLMは公式NVFP4・WSL2・22.9GB。通常の生成。vLLM 0.32.1rc1.dev353+g2d40c0609、llama.cpp b11804-c7fc50941。研究版・表示条件での結果です。
品質表は別構成の混合4/8bit版:20.635GB、元BF16とのTop1一致率85.14%、PPL 12.959。同じ53,196予測位置で評価。Top1は課題の正答率ではなく、計算・KV形式の差も含みます。速度映像は従来4bit版です。
個人で開発しているローカルAIエンジン
「YASAKANI」の、現状の結果です。
オープンソースで、無料で公開する予定です。
日程はこのアカウントでお知らせします。
Qwen3.8 27b のシングルでは最大2.8倍出ております!
是非↓も確認してくださいm(_ _)m
xitter.twitterapi.xyz/yasakani_dev/status/21…
SGLang、vLLM、llama.cpp。
世界中で使われているエンジンに、同じ RTX 5090 で 10 戦全勝しました。最大 2.86 倍。
しかも、
・相手はテストごとに一番速い設定、こちらは 2 回測った遅いほうの数字です。
・相手の SGLang と vLLM は Linux(WSL2)、こちらは Windows のまま
・高速化が効きにくい普段の文章でも 2 倍超え(文章 3 問 2.02 倍、NInfer 公式の文章でも 2.31 倍)
個人で開発しているローカル AI エンジン「YASAKANI」の、現状の結果です。
オープンソースで、無料で公開する予定です。日程はこのアカウントでお知らせします。
SGLang、vLLM、llama.cpp。
世界中で使われているエンジンに、同じ RTX 5090 で 10 戦全勝しました。最大 2.86 倍。
しかも、
・相手はテストごとに一番速い設定、こちらは 2 回測った遅いほうの数字です。
・相手の SGLang と vLLM は Linux(WSL2)、こちらは Windows のまま
・高速化が効きにくい普段の文章でも 2 倍超え(文章 3 問 2.02 倍、NInfer 公式の文章でも 2.31 倍)
個人で開発しているローカル AI エンジン「YASAKANI」の、現状の結果です。
オープンソースで、無料で公開する予定です。日程はこのアカウントでお知らせします。
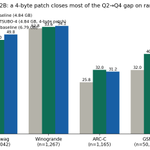
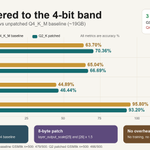
🚨2-bit Gemma 4 31B recovered to near 4-bit baseline performance by changing only 8 bytes.
Q2_K patched (~12.6GB) vs unpatched Q4_K_M baseline (~19GB):
HellaSwag
70.36% > 63.70% (+6.66pt)
Winogrande
66.69% > 65.04% (+1.65pt)
ARC-Challenge
46.44% > 44.89% (+1.55pt)
GSM8k
93.20% < 95.80% (-2.60pt)
So the honest result:
Q2_K patched beats Q4_K_M baseline on 3/4 benchmarks.
GSM8k remains Q4-favored.
Across all four, Q2_K patched is within 0.69pt of unpatched Q4_K_M baseline.
Patch:
layer_output_scale[25] *= 1.5
layer_output_scale[26] *= 1.5
Two float32 values.
8 bytes total.
No training.
No calibration.
No inference overhead.
Paper:
doi.org/10.5281/zenodo.20362…
Code:
github.com/morphicode-jp/f32…
HF Q2_K:
huggingface.co/morphicode-jp…
HF Q4_K_M:
huggingface.co/morphicode-jp…
1/5 1-bit jumps to 60%. 4-bit just beat Q8.
Gemma 4 31B-it just proved low-bit LLMs are back — and stronger than ever.
Remarkably:
1-bit (IQ1_M, 9.5 GB) on GSM8k → 24% → 60% (+36.0pt)
The largest improvement across all 12 cells.
And 4-bit patched beats Q8 BF16 baseline on every single benchmark.
No training. No calibration. No inference overhead.
The conventional wisdom on low-bit LLMs has been completely overturned.
🤖 Made with AI
2/5 4-bit patched beats 8-bit baseline on every benchmark.
Q4_K_M patched (19 GB) vs Q8_0 BF16 baseline (31 GB):
HellaSwag 73.50% > 63.33% (+10.17pt)
GSM8k 87.00% > 70.00% (+17.00pt)
Winogrande 70.32% > 65.59% (+4.73pt)
ARC-C 48.76% > 44.38% (+4.38pt)
4-for-4 victory.
And ~40% smaller (19 GB vs 31 GB).
🤖 Made with AI